Article
CUDA笔记-编程模型
整理CUDA中的编程模型相关概念
编程模型并不仅局限于某一个特定的语言, 而是一种抽象, 在CUDA手册中主要以c++语言来呈现所介绍的编程模型的概念, 后续切换到其他的DSL也类似, 如TileLang.
Heterogeneous Systems
CUDA编程模型假定是在异构系统上进行开发, 异构系统同时包含了CPU侧和GPU侧, CPU以及CPU直接相连的内存分别被称为host以及host memory;CPU以及CPU直接相连的内存分别被称为device和device memory.
CUDA编程模型并不假定CPU和GPU的数量以及它们物理上是如何连接的, 例如片上系统(system-on-chip, SOC), CPU和GPU可能被焊在同一块芯片上, 其内存也可能是统一寻址的, 但这不影响将CPU侧和GPU侧逻辑上分开. 对于大型系统, 可能包含有多个CPU和GPU, 我们将多个CPU以及它们连接的内存统一称为Host侧, 将GPU以及它们相连的内存统一称为Device侧.
CUDA程序会在GPU上执行部分代码, 而程序入口一般是在CPU上运行. Host端的代码能够通过CUDA API将数据在host memory和device memory之间移动, 运行device侧的代码, 以及等待device侧代码运行以及数据同步的结果. CPU和GPU通常并行去执行代码, 优化的目标通常是最大化利用CPU和GPU资源.
在GPU上执行的代码通常被称为device code, 在GPU上执行的函数一般被称为kernel. 启动一个kernel的运行一般被称为launching kernel. Launch kernel主要是在GPU上启动多个线程执行kernel.
GPU Hardware Model
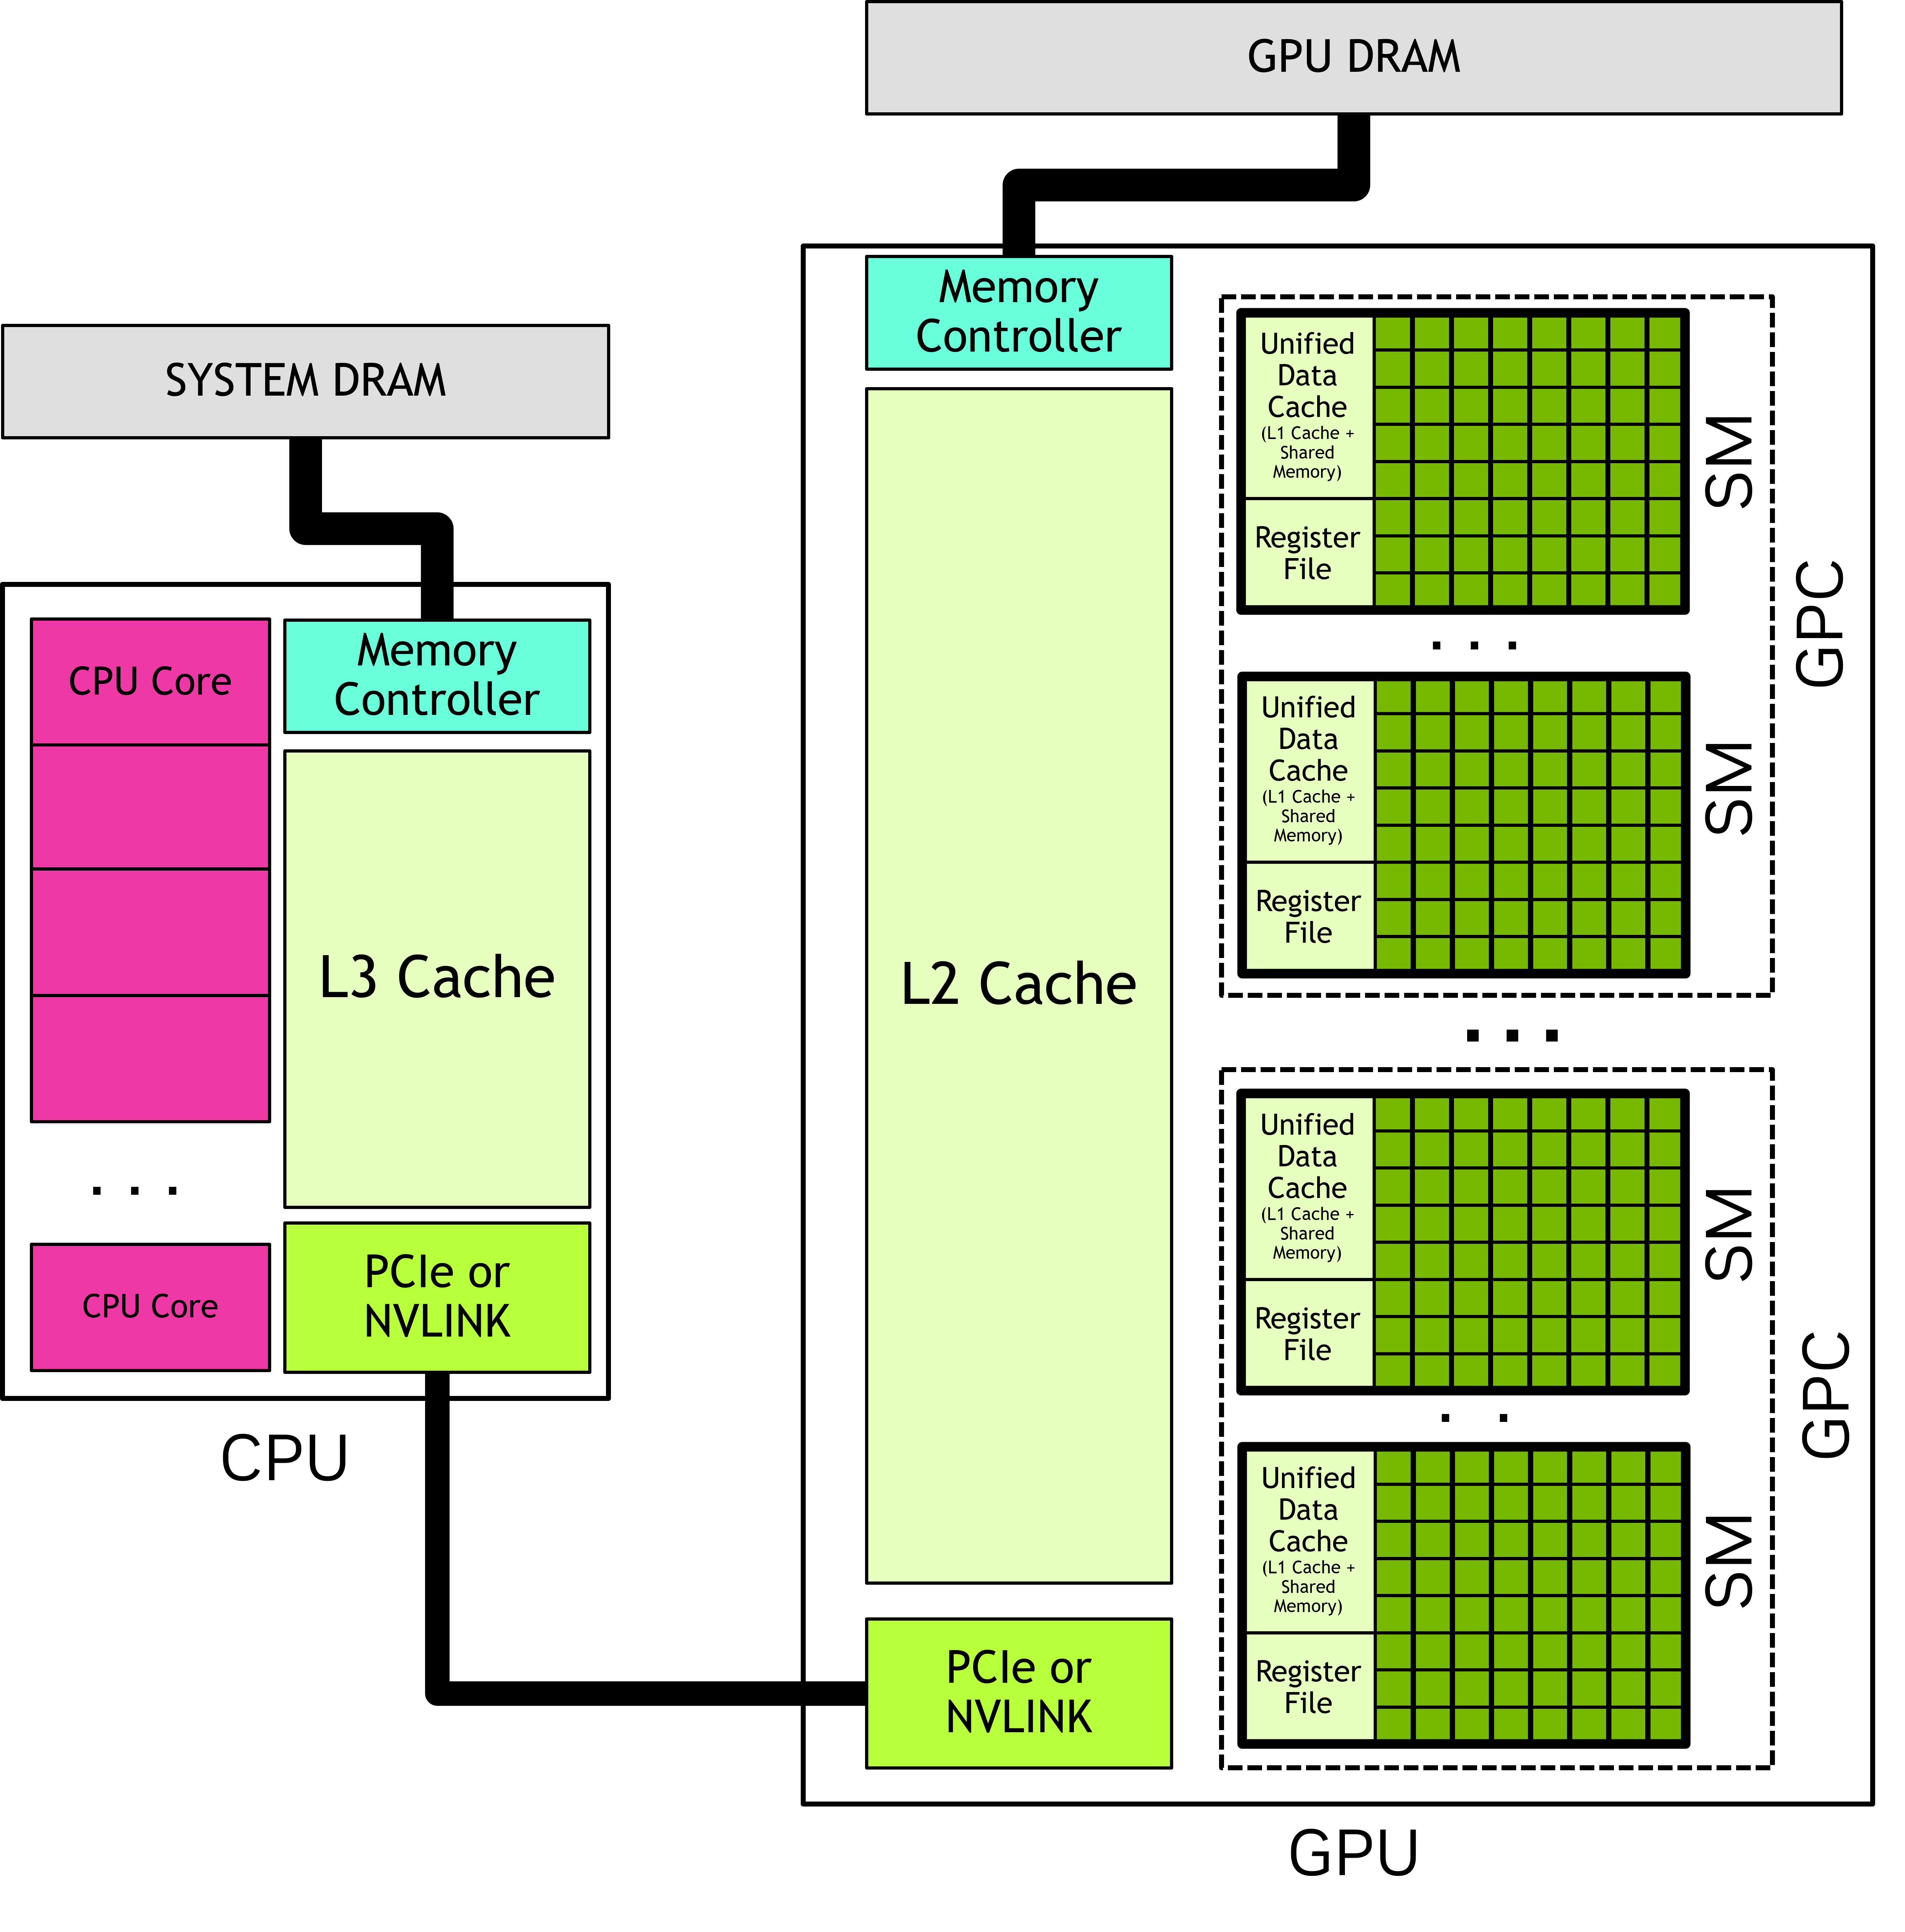
CUDA编程模型是对其底层硬件实现的一层概念抽象. 基于CUDA模型, GPU可以被认为是多个流式多处理器(Streaming Multiprocessors, SMs)的集合, 多个SM构成一个图像处理集群(Graphic Processing Cluster, GPC), 多个GPC与GPU Memory连接构成GPU. CPU与GPU之间通过PCIe或者NVLINK相连. 每个SM都包含一个局部寄存器文件(Local Register File), 一块统一数据缓存(Unified Data Cache, L1 Cache + Shared Memory)以及若干个计算单元用于执行具体的计算. 在程序运行时, 可以动态分配L1 Cache和Shared Memory在统一数据缓存中的大小. 不同GPU架构的情况下, SM中所包含的计算单元数量, 内存类型和大小也可能不同.
Thread Blocks and Grids
当我们从Host侧启动一个kernel的时候, 实际上会启动许多的GPU线程来执行这段kernel代码. 若干个GPU线程组成一个线程块(Thread Block), 多个线程块组成一个网格(Grid), 网格内的Block维度大小相同. 这些都是逻辑概念.
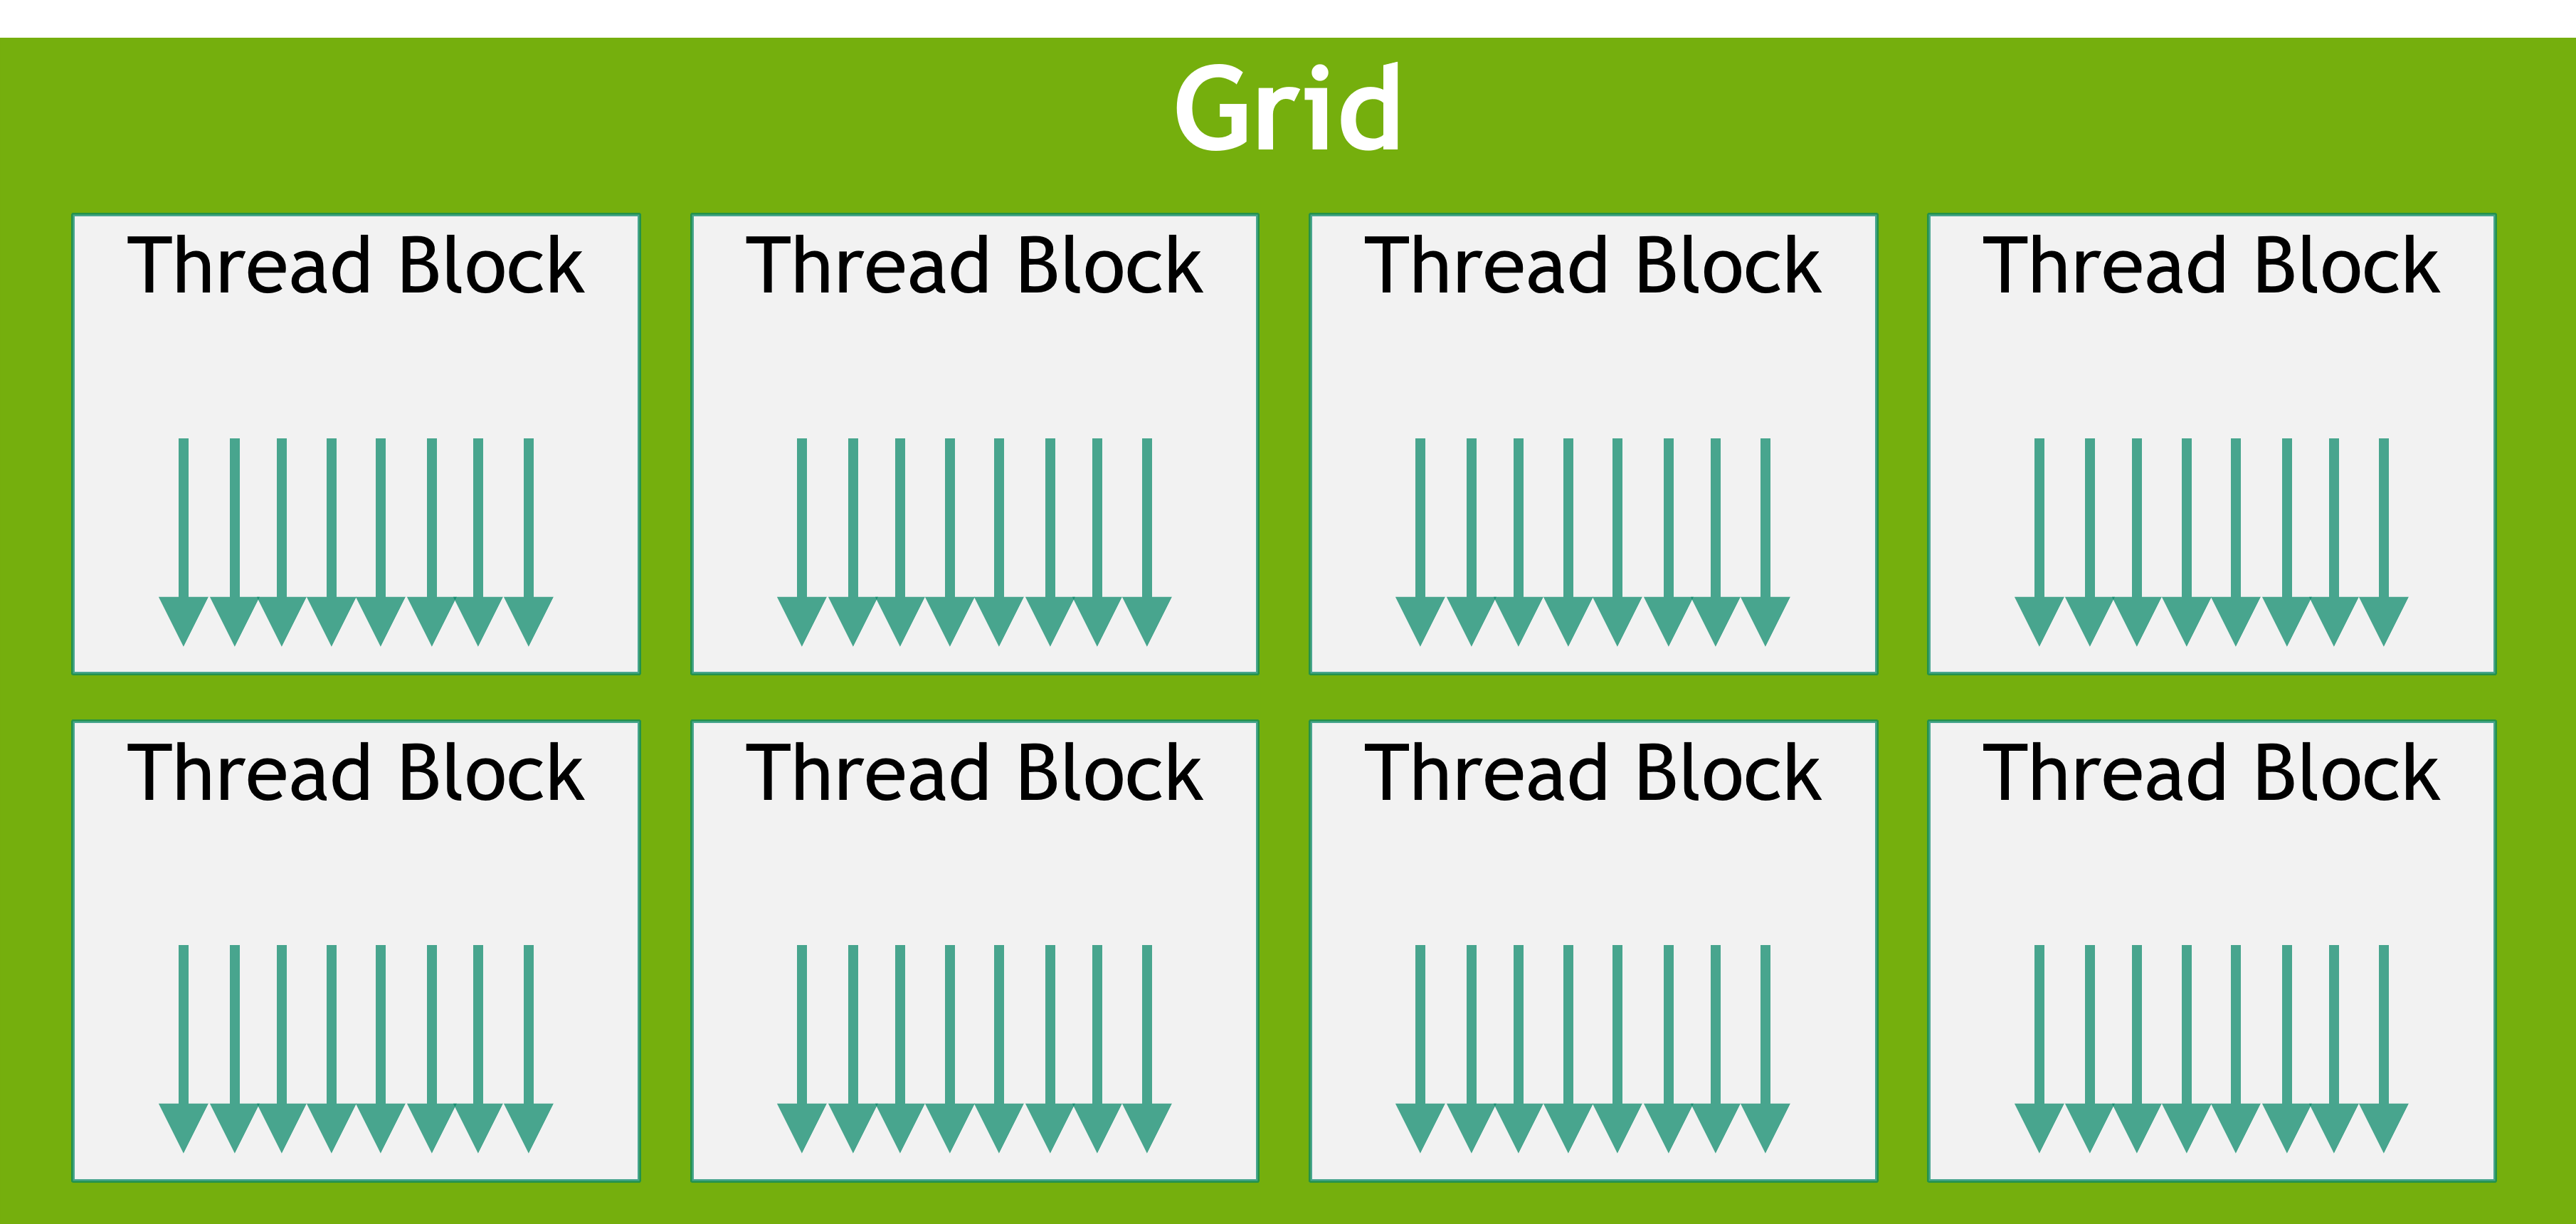
Grid和Block的维度可以指定为1, 2, 3维从而减少将数据映射到对应线程的复杂度. 当启动一个kernel的时候, 一般会要求我们指定grid和block的配置(通过<<<gridDim, blockDim>>>), kernel的执行配置中还可以配置一些可选项, 如Cluster的大小, Stream以及SM的设置.
通过CUDA内置变量如threadIdx/blockIdx等可以来确定线程以及线程块所在的位置, 从而用于决定当前线程应该对哪一部分数据进行操作.
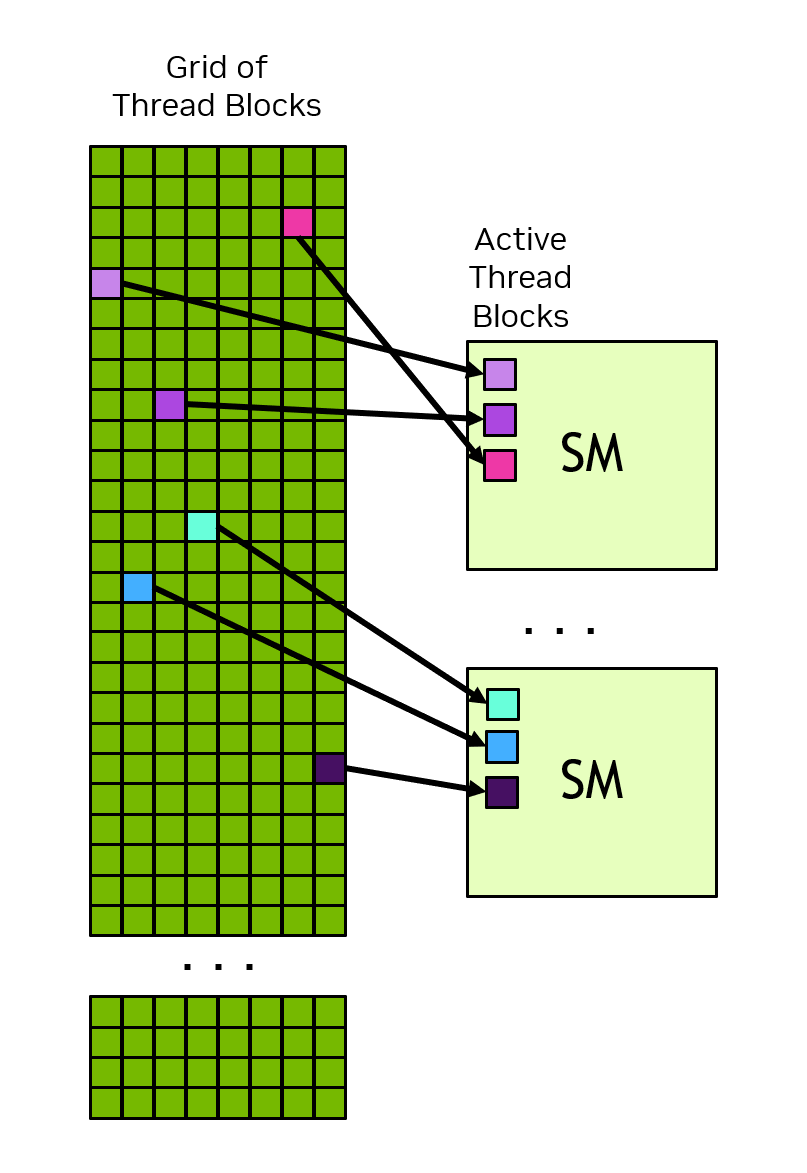
线程块是SM调度的单元, 同一个线程块中的线程可以访问SM上的共享内存从而交换信息. 一般而言, 调度到SM上的线程块会在该SM上一直阻塞执行直到完成, 然后切换到下一个线程块执行. 当开启了CUDA Dynamic Parallelism的情况下, 线程块执行过程中可能会被换出, 并将其上下文信息保存到显存中, 等待下一次调度. SM并不对block的调度顺序进行保证, 因此不同的block之间不能有相互依赖的关系.
Thread Block Clusters
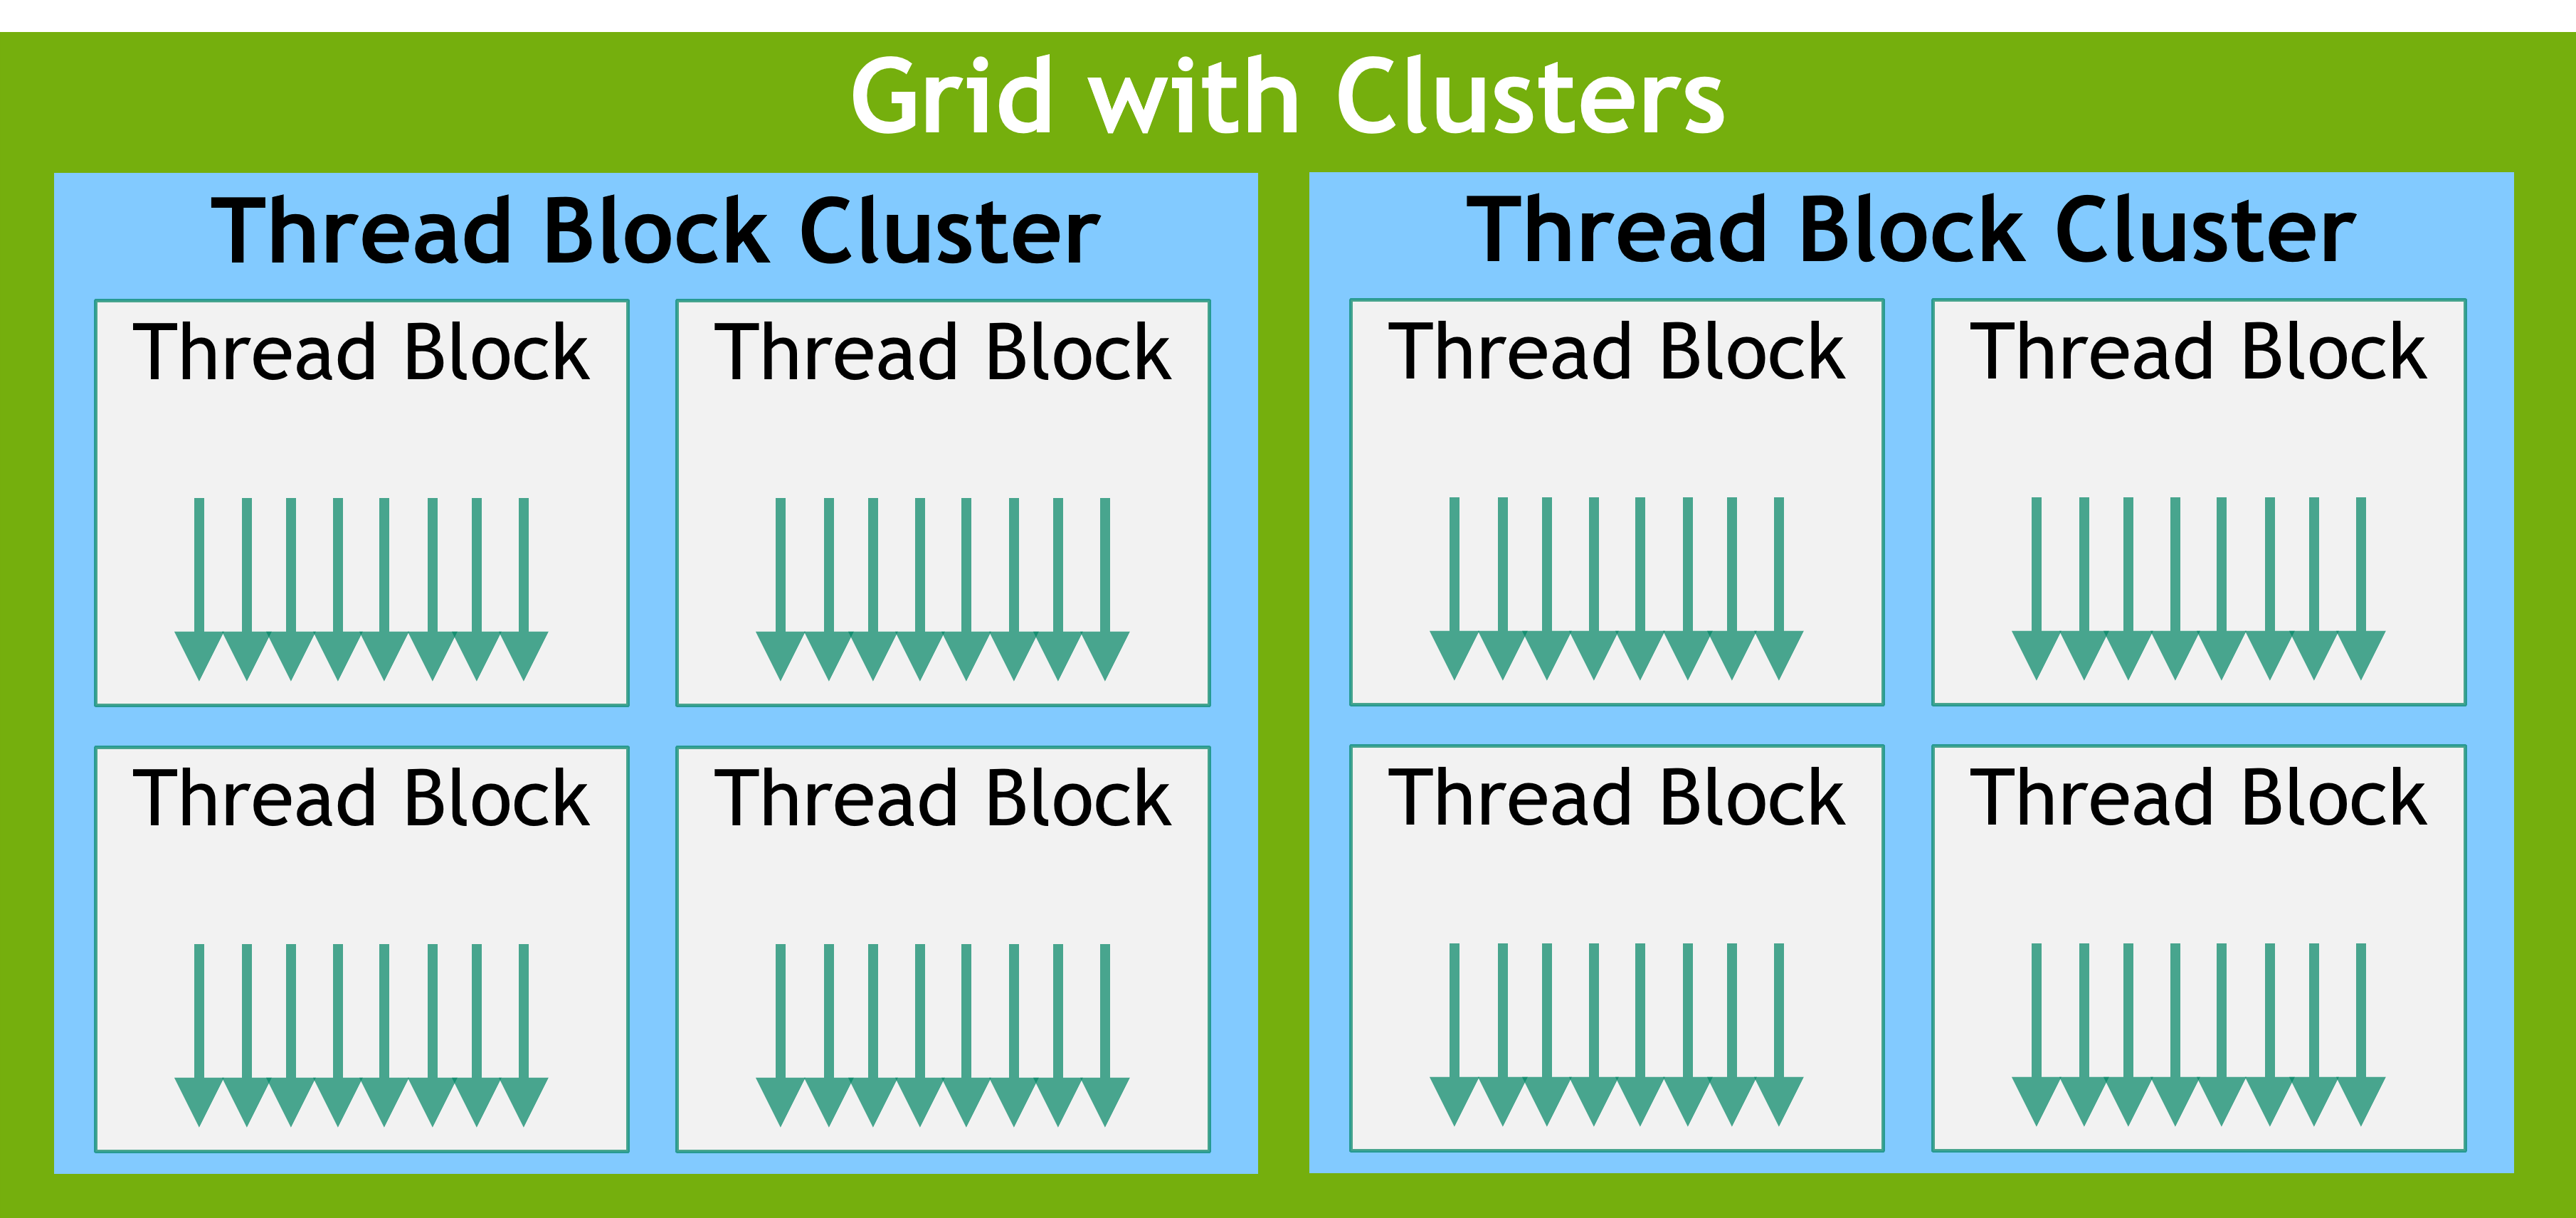
在CC 9.0之后, 多个线程块被组织为一个线程块集群(Thread Block Cluster), 线程块集群同样可以有3个维度. 同一个集群中的线程块可以在集群内进行同步和通信。同一个集群上的线程块会放到一个GPC中执行,GPC中有一块共享内存(distributed shared memory)可以供同一个GPC上的线程块访问,因而在同一个cluster中的线程可以通过由Cooperative Groups提供的API来进行同步和通信。
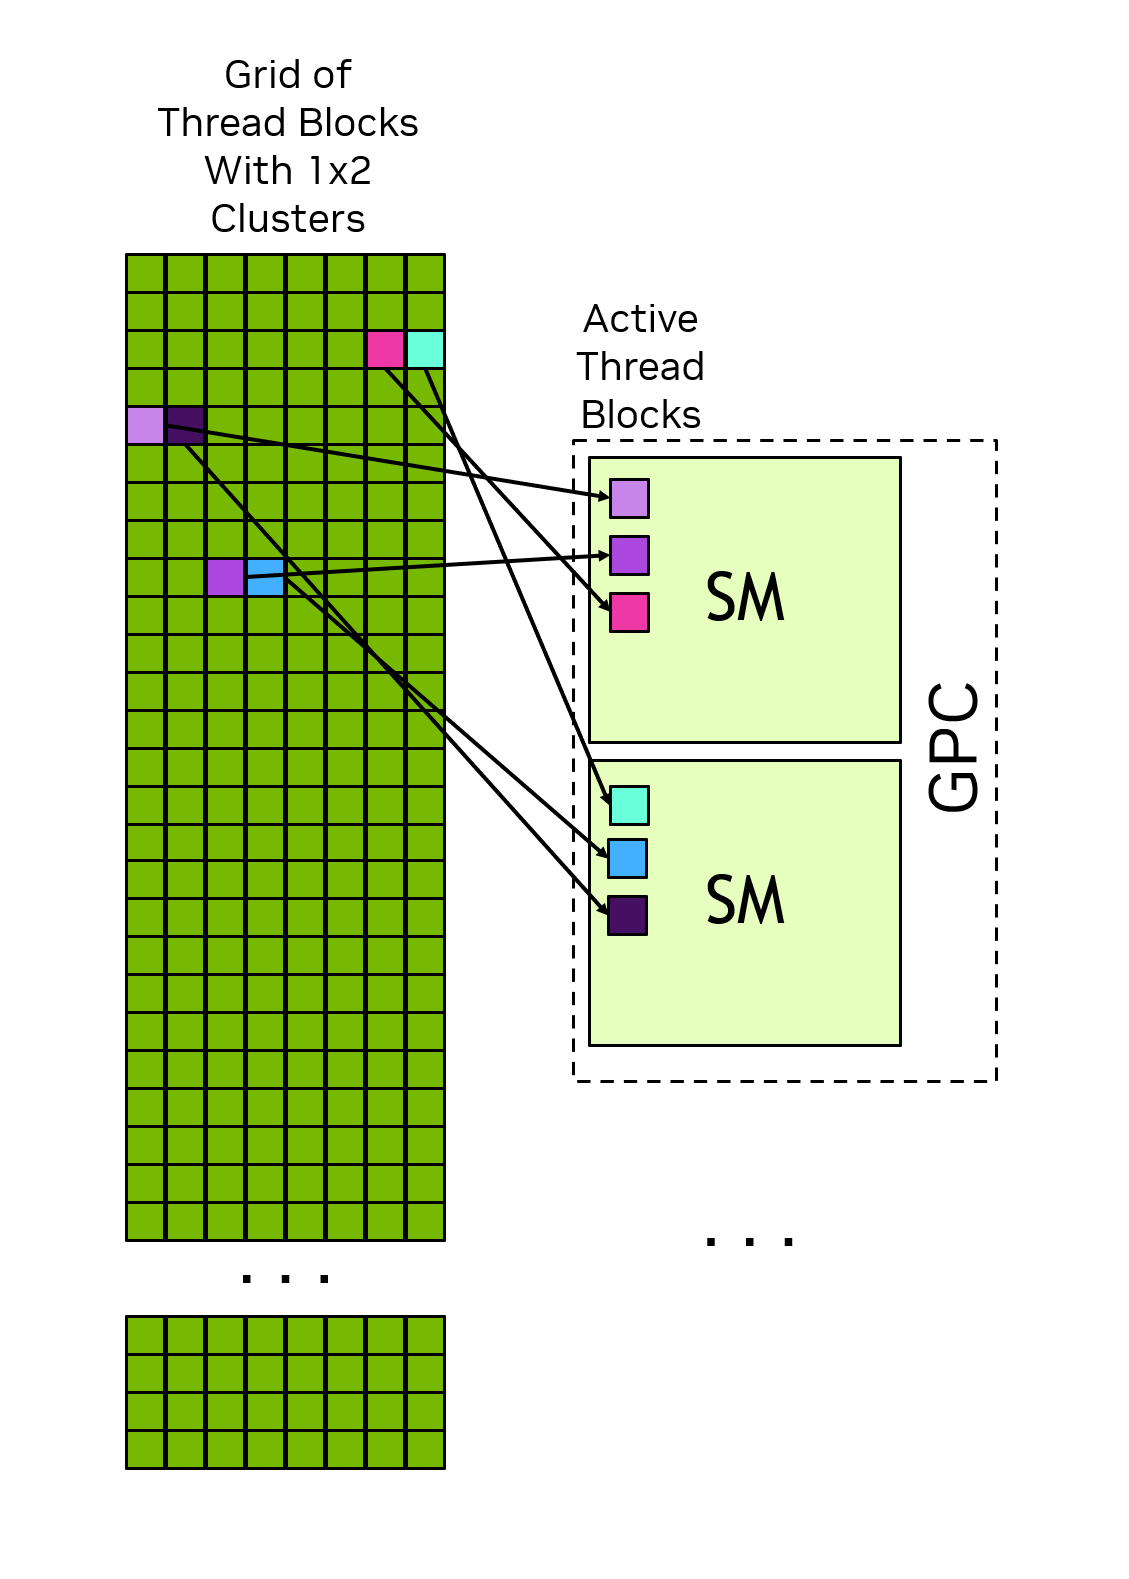
同一集群的线程块在Grid中总是相邻的。
Warps and SIMT
在线程块中,32个线程构成的集合被称作是一个warp,同一个warp中的线程在执行kernel代码时以(Single Instruction Multiple-Threads, SIMT)的模式执行,即这32个线程都执行同一份kernel代码,但这些线程走的分支流不一定是相同的。当一个warp中的线程执行代码时,每个线程都会被分配到一个warp lane,具体划分方式见Hardware Multithreading。在执行指令流的时候,如果某些线程不走某个分支的指令流,那么这些线程会被mask起来,其他线程会继续执行。
当同一个warp中的线程需要执行不同的分支流的时候,我们就说这时候发生了warp divergence,出现warp divergence的时候通常意味着此时GPU的利用率变小了,因此我们希望尽可能减少这种情况的发生。
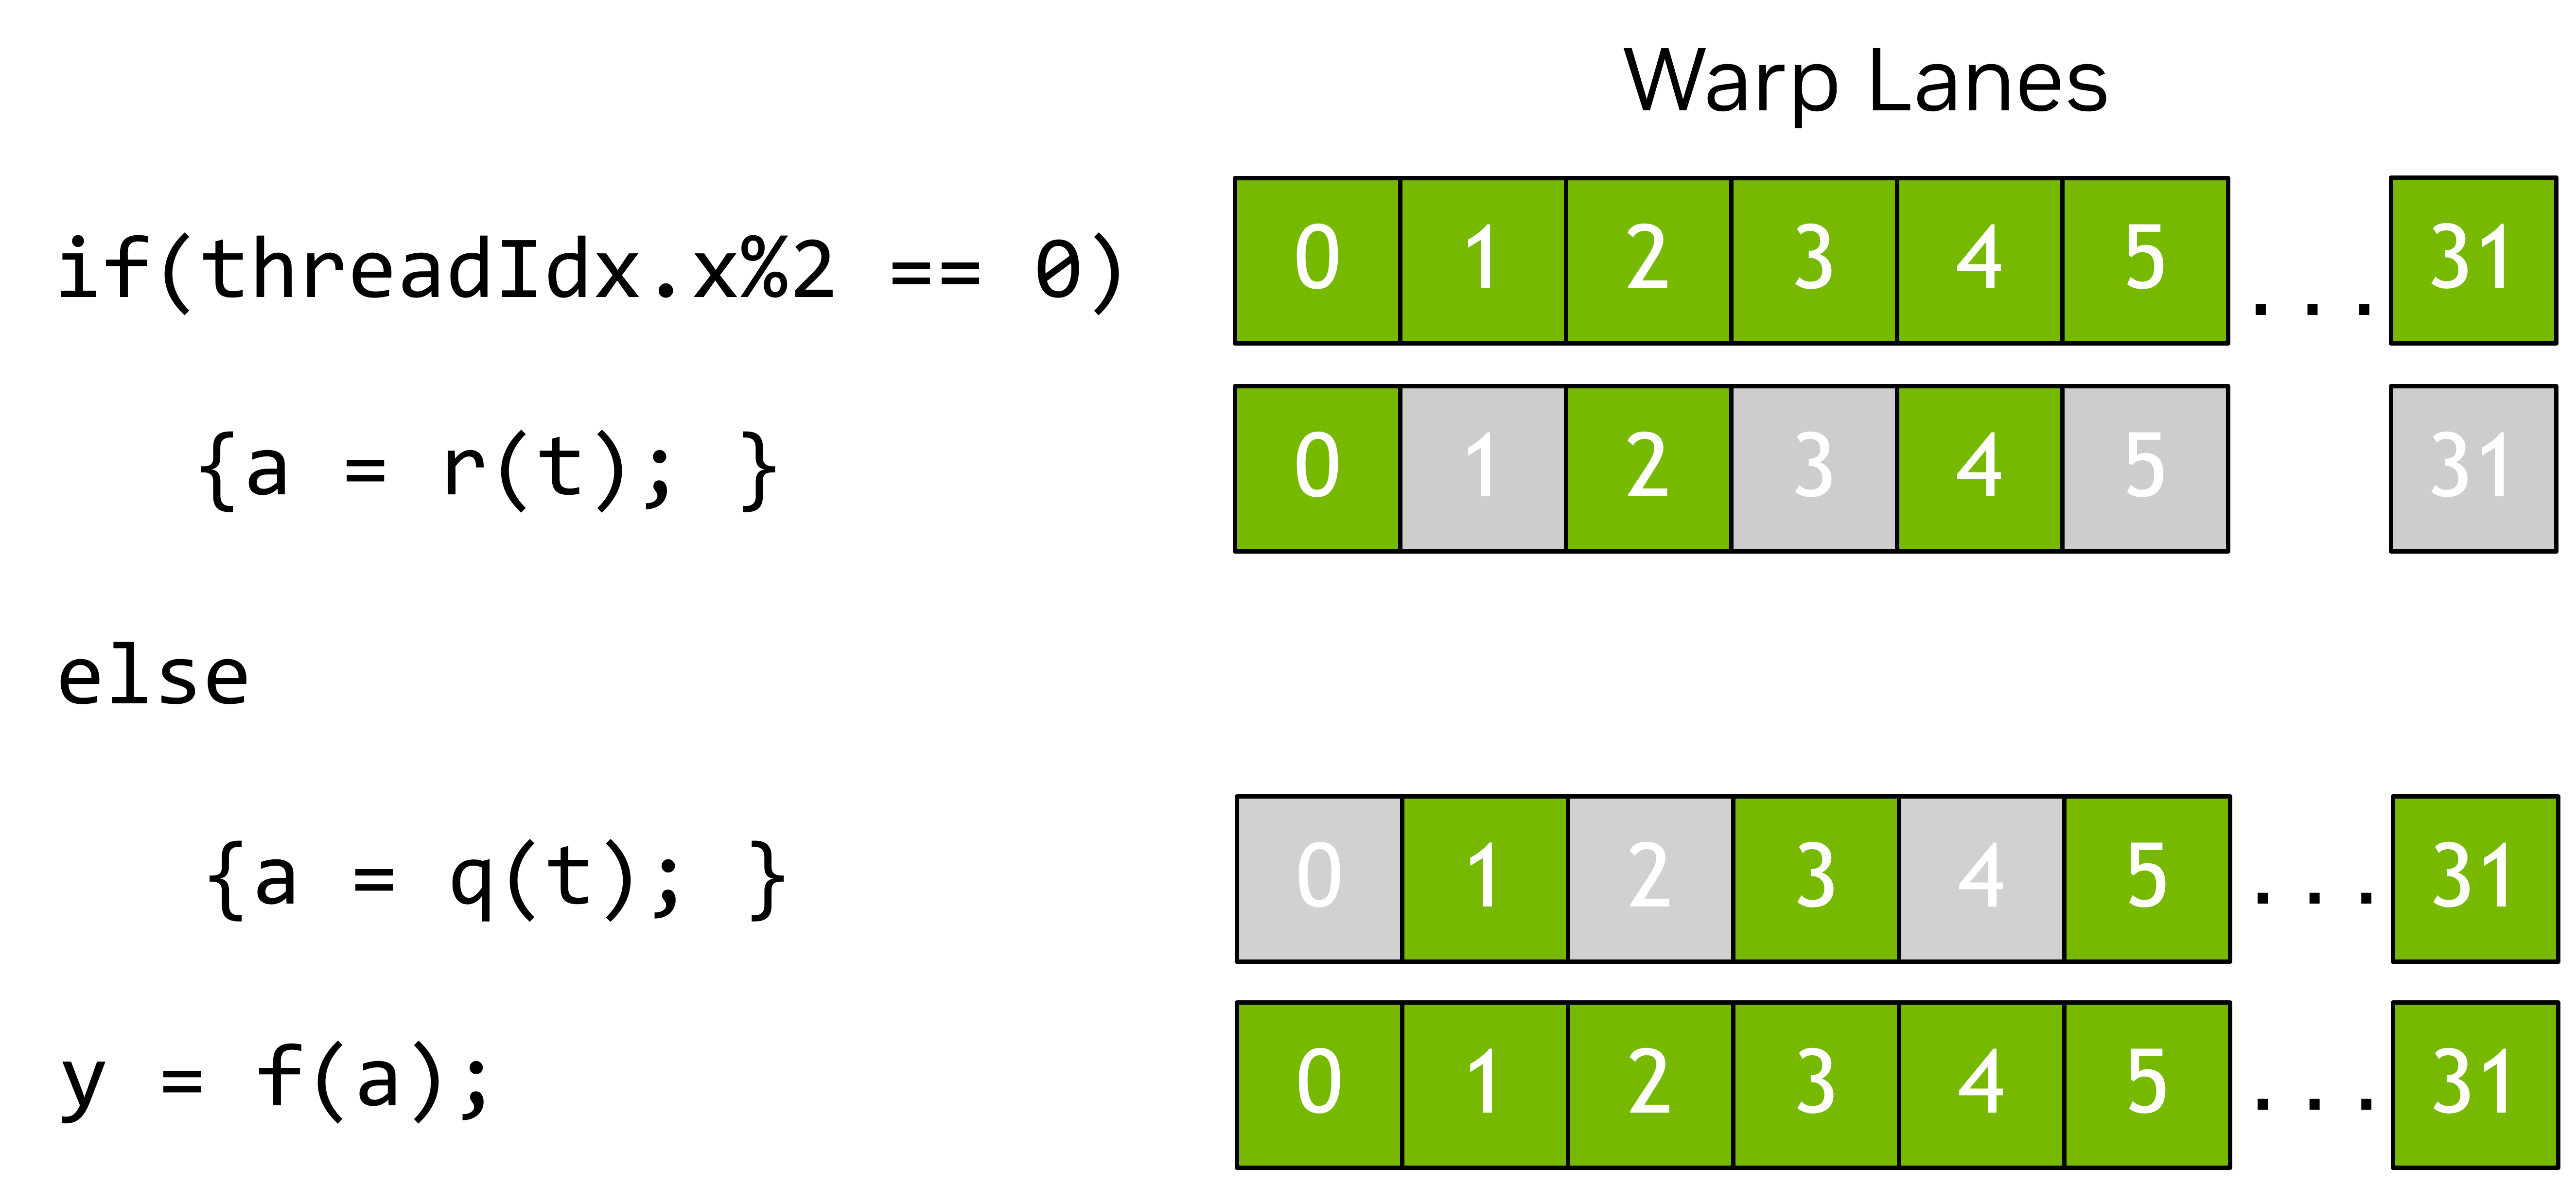
SIMT模型中,同一个warp内的线程是以锁步(lock step)的方式执行的,但其真实硬件的执行方式可能不一样,例如在Volta之后支持的独立线程调度实际上并不一定让每个线程逐拍同步执行。因此我们不能以观察得到的硬件结果作为依赖来写代码,例如某次发现warp内的线程都是逐拍同步的,因此就不写__syncthreads()等.
通过熟悉同一warp内的线程的执行方式,我们可以减少warp divergence,从而优化GPU资源的利用率.
TODO: 阅读
通过warp的组织方式,我们可以得到的一个信息是,thread block内指定的threads数量最好是32的整数倍,不然最后一个warp里面的lanes会分配不满。
SIMD与SIMT的区别:
- SIMD是一条指令对多个数据执行一样的指令,寄存器上各个数据宽度是一样的,且在divergence出现时,是算两遍,把两个结果按掩码来挑选,从程序员视角看就是一个向量数据。
- SIMT的话并不会对数据宽度做限制,在divergence出现时,是对不走该分支的thread做mask,实际上被mask的thread直接不执行,从程序员视角看是大量并行的threads.
Tile Programming in CUDA
CUDA已经正式支持了按Tile Programming Model来写代码,具体来说,程序员直接打交道的对象从thread变成了thread block,不是直接去关心某个thread应该如何处理某个数据,而是关心某个thread block上应该对一个多维矩阵做运算。这里将一个多维的矩阵数据称为一个tile,程序员只需要指定grid dimension,编译器会根据kernel代码中的tile上的操作来决定thread block中应该有多少个threads.
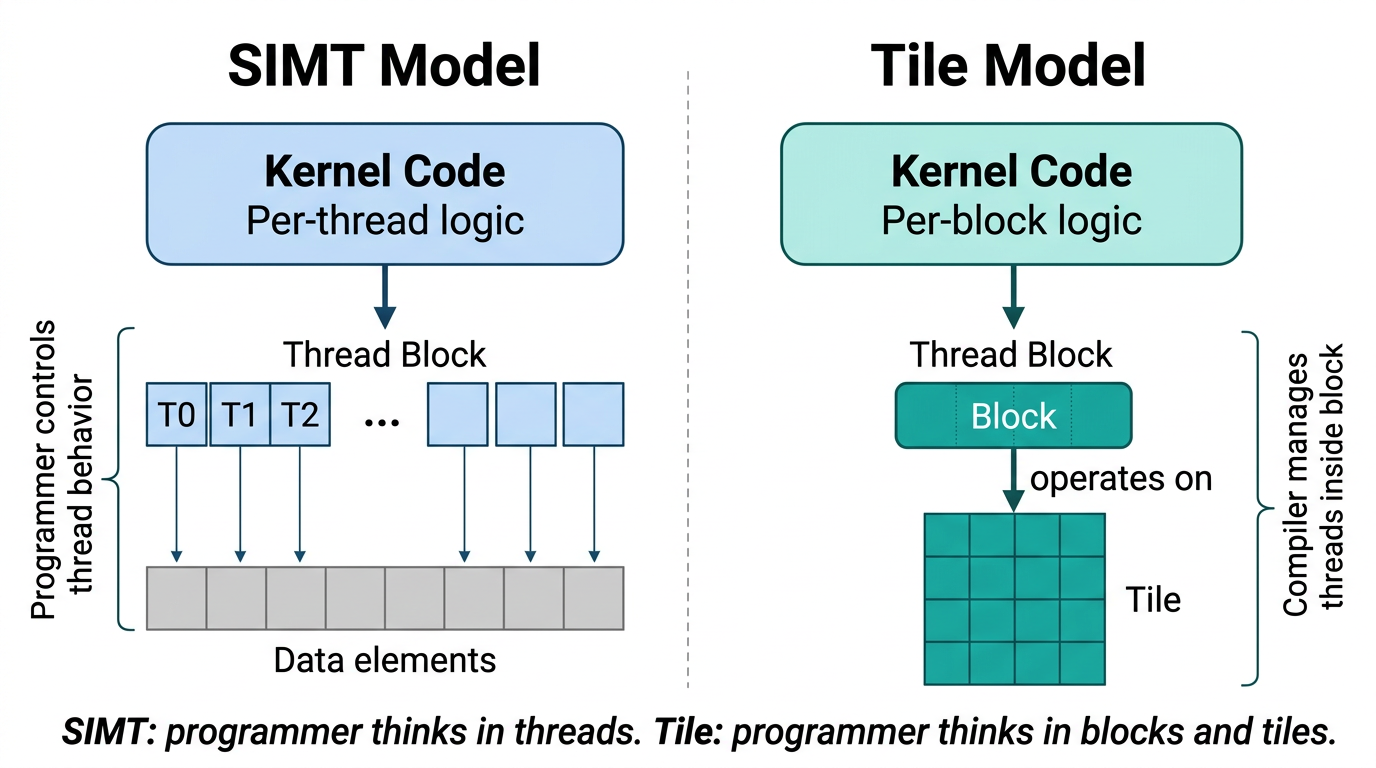
在Tile Kernel中,整个block执行同一指令流。程序员指定的是thread block级别应该怎么对tile进行操作,因而不存在warp divergence的概念,这个有点像是把语言层的表述从SIMT变成了SIMD,但没有对数据宽度做限制,当然底层依然还是SIMT的。在Tile Kernel中,对于标量操作,并不会让所有的线程都去做,而是编译器指定一个线程做,然后通过uniform数据通路将该数据广播给其他线程,如loop bound之类的。对于Tile操作,例如把两个Tile逐元素相加,这种会把对应的操作分配给线程块中的各线程去执行。
Arrays and tiles
Tile Kernel可以对两种类型的数据进行运算,包括array和tile.
-
array: 是存储在device memory中的多维元素容器,默认是可变的(mutable),可以通过store操作修改里面的内容,一个array需要包含形状以及数据类型。 -
tile: 多维值的集合,并且其生命周期仅存在于单个thread block以及某段tile code中(不能作为kernel parameter传),tile是不可变的,tile操作会生成一个新的tile作为输出,tile由编译器决定其存放位置,可能在寄存器、共享内存,或者SM的其他资源上(L1 cache)。tile的各个维度必须是2的倍数,且必须是编译时确定的。
Tile space and data movement
将数据在array和tile之间移动的操作被称为是load操作,对于一个形状为(M, N)的array来说,假设我们指定tile的shape为(t_m, t_n),则整个array被划分为ceildiv(M, t_m) * ceildiv(N, t_n)个tile,可以用(i, j)来索引对应的tile,load操作会根据指定的索引返回对应的tile,当边界没对齐时,load操作应指明如何处理边界,例如填充0.
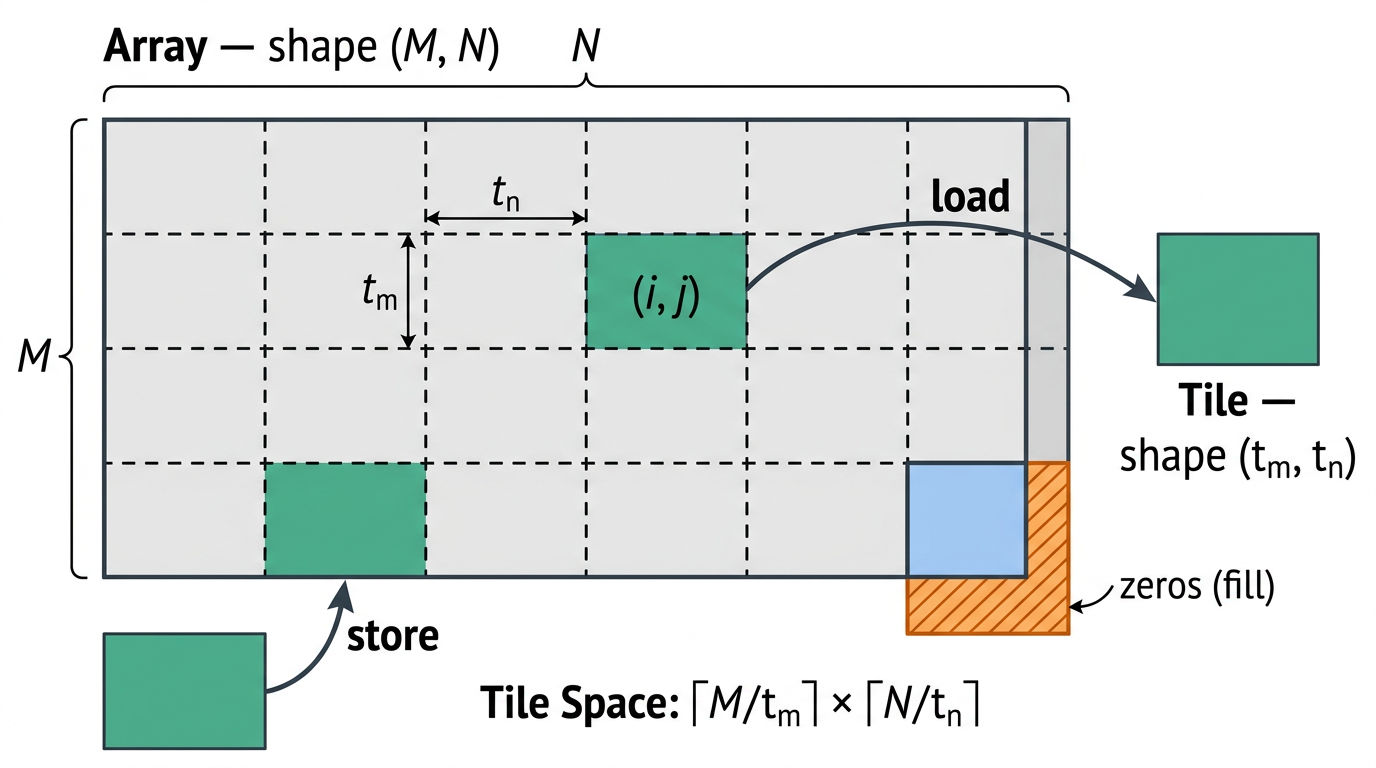
store操作与load操作相反,是将tile中的内容写回对应的array,超出边界的部分会被直接丢弃. Tile program同时支持了gather和scatter操作,能够从array的任意位置读取和写入内容.
Operations on tiles
Tile program提供了一些builtin的函数供开发使用,当两个shape的tile作为输入时,小尺寸的tile会自动对齐大尺寸的tile.
Relationship to SIMT Programming
同一个程序中, 编写某个kernel时可以选择使用Tile Programming或者是SIMT Programming, 两者可以共存, SIMT Programming提供了更细粒度的控制, Tile则能够简化kernel的开发(具体的线程级决策方案由compiler给出, 因此在变更GPU架构时无需对源码进行改动), 这两种编程模型的底层硬件支持一致, 所使用的设备内存空间也是一致的, 只是上层抽象有所不同.
GPU Memory
在现代的计算系统中, 充分利用内存与充分利用计算能力同等重要, 异构的系统通常包含多个内存空间, GPU上包含了多种的片上内存以及缓存.
DRAM Memory in Heterogeneous Systems
CPU与GPU都直接与DRAM芯片相连, 当存在多个GPU时, 每个GPU都拥有其自己的内存空间. 从device端代码来看, GPU拥有的内存空间被称为是global memory, 因为该GPU上的所有SM都具有访问它的能力(不代表其他GPU或者CPU能够访问). 连接在CPU上的内存被称为是system memory或者host memory.
GPU上有类似于CPU的虚拟地址机制, 在现代系统中, GPU和CPU使用统一虚拟地址空间, 这意味着某个虚拟地址会唯一对应于某个GPU/CPU上的物理地址.
通过CUDA API, 可以在CPU和GPU上申请内存, 同时可以在CPU与GPU, GPU与GPU之间拷贝数据. 采用Unified Memory可以让CUDA runtime或者系统硬件自动管理内存的分配.
On-Chip Memory in GPUs
除了与GPU相连的DRAM芯片所提供的global memory, GPU上还拥有片上内存. 每个SM上都包含了其特有的寄存器文件以及共享内存, 执行在SM上的线程可以直接访问SM上的这些内存地址.
寄存器文件一般用于存放线程的局部变量, 共享内存部分可以存放数据用以同一个线程块或者线程块集群内的线程访问.
每个SM上的内存大小是有限制的, 在不同的计算能力版本下, 内存分配的方式也有所不同, 具体可见Memory Information per Compute Capability.
为了将线程块调度到SM上, 其内部线程存放局部变量所需要的寄存器数量必须要小于等于SM上可用的寄存器数量, 否则无法启动该kernel.
与寄存器文件上的内存一般是在单个线程内部进行申请不同, 共享内存上的内存申请一般是线程块维度的.
需要说明的是, 片上内存申请并不是动态完成的, 在编译器就必须确定shared memory的大小, 在launch kernel时compiler会进行检查并一次性分配. 例如
__shared__ int s[100];
Caches
GPU上拥有L1和L2 cache, L1 cache在SM的unified memory中, L2 cache则是在GPU上供所有的SM能够访问. SM上还有一块叫做constant cache的区域(不同于L1 cache), 用于缓存global memory中的一些常量值, 如kernel中被声明为constant的那些值, 这些常量值的生命周期与kernel一致, compiler有时会将kernel parameter也放在里面.
Unified Memory
当某个程序手动申请GPU上的内存时, CPU侧是不能够访问这块内存的, 只有GPU侧运行的kernel可以访问这块内存, 同理申请CPU时, GPU侧也不能访问这块内存. 如果需要交换数据, 则需要通过copy等完成数据传输.
有一个例外是mapped memory允许GPU直接访问CPU侧的内存, 这是对于CPU上页锁定内存而言(不能被OS换走的那些页), 这些页直接映射进GPU的地址空间, 这样一来GPU每次需要访问这块内存的时候都需要通过NVLINK或者PCIe去访问host memory, 但NVLINK和PCIe的带宽低, 而延迟又高, 不便于靠并行隐藏延迟.
CUDA提供了一个叫做unified memory的机制, 允许开发者从代码层面来看可以直接访问CPU和GPU上的内存. 其底层依然保持host端数据放在host memory上, device端数据放在device memory上, 统一内存并不意味着零拷贝, 有点类似于自动管理的Copy操作, 但如果代码高频地在CPU和GPU之间访问同一块数据从而导致数据频繁在host memory和device memory之间搬运, 也会导致性能很差.
一个好的方案是CPU一次性准备大块输入, 预读取(cudaMemPrefetchAsync, cudaMemAdvise)到GPU中, GPU频繁做计算, 然后将数据拷贝回CPU.
系统的硬件特性决定了Unified Memory上访问和交换数据的具体实现方式, 见Unified Memory.